
Web crawler adalah program otomatis yang digunakan untuk menemukan, mengakses, dan mengambil halaman atau sumber daya di web.
Dalam mesin pencari seperti Google, crawler membantu menemukan halaman baru atau halaman yang diperbarui sebelum informasi tersebut dianalisis dan diproses untuk indexing.
Proses crawling merupakan salah satu bagian penting dari cara kerja mesin pencari dan berkaitan erat dengan SEO.
Untuk memahami hubungan crawling dengan SEO secara keseluruhan, baca juga panduan apa itu SEO.
Saat Anda menggunakan search engine untuk mencari informasi di internet, web crawler atau web spider bekerja di belakang layar untuk menelusuri berbagai halaman web dan menemukan informasi yang tersedia di dalamnya.
Apa itu Web Crawler?
Pengertian Web crawler merupakan sebuah bot atau program yang diaplikasikan banyak mesin pencarian dalam mengumpulkan dan menelusuri data-data di internet.
Program ini dapat menganalisa konten situs web sekaligus menyimpan informasi di dalam sistem database mesin pencarian itu sendiri.
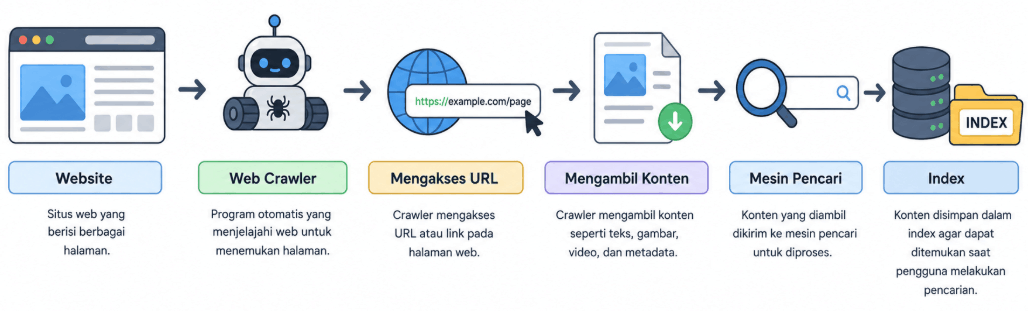
Sementara itu, crawling adalah proses selama program crawler menelusuri dan menganalisis konten web.
Untuk istilah indexing sendiri merujuk pada proses dalam penyimpanan informasinya.
Ketika anda mencari sebuah informasi tertentu di internet, mesin pencari yang dipakai akan menemukan informasi yang paling relevan pada sistem database mereka.
Setelah itu, data akan ditampilkan di dalam search results pada web browser anda. Menariknya, setiap mesin pencari memiliki web crawler berbeda.
Ada beberapa contoh web crawler dari mesin pencari terpopuler berikut :
- GoogleBot, diaplikasikan untuk menyimpan dan mengindex konten web dalam database Google.
- Baiduspider, bot yang diaplikasikan oleh Baidu sebagai salah satu mesin pencari populer yang ada di China.
- Duckduckbot, adalah web crawler yang dipakai oleh DuckDuckGo dalam menyimpan dan menelusuri informasi/data.
- Bingbot, merupakan crawler yang dirilis oleh Microsoft pada tahun 2020 lalu untuk penyimpanan data dalam database mesin pencari Bing.
- YandexBot, adalah crawler dari Yandex sebagai search engine terkemuka di Rusia.
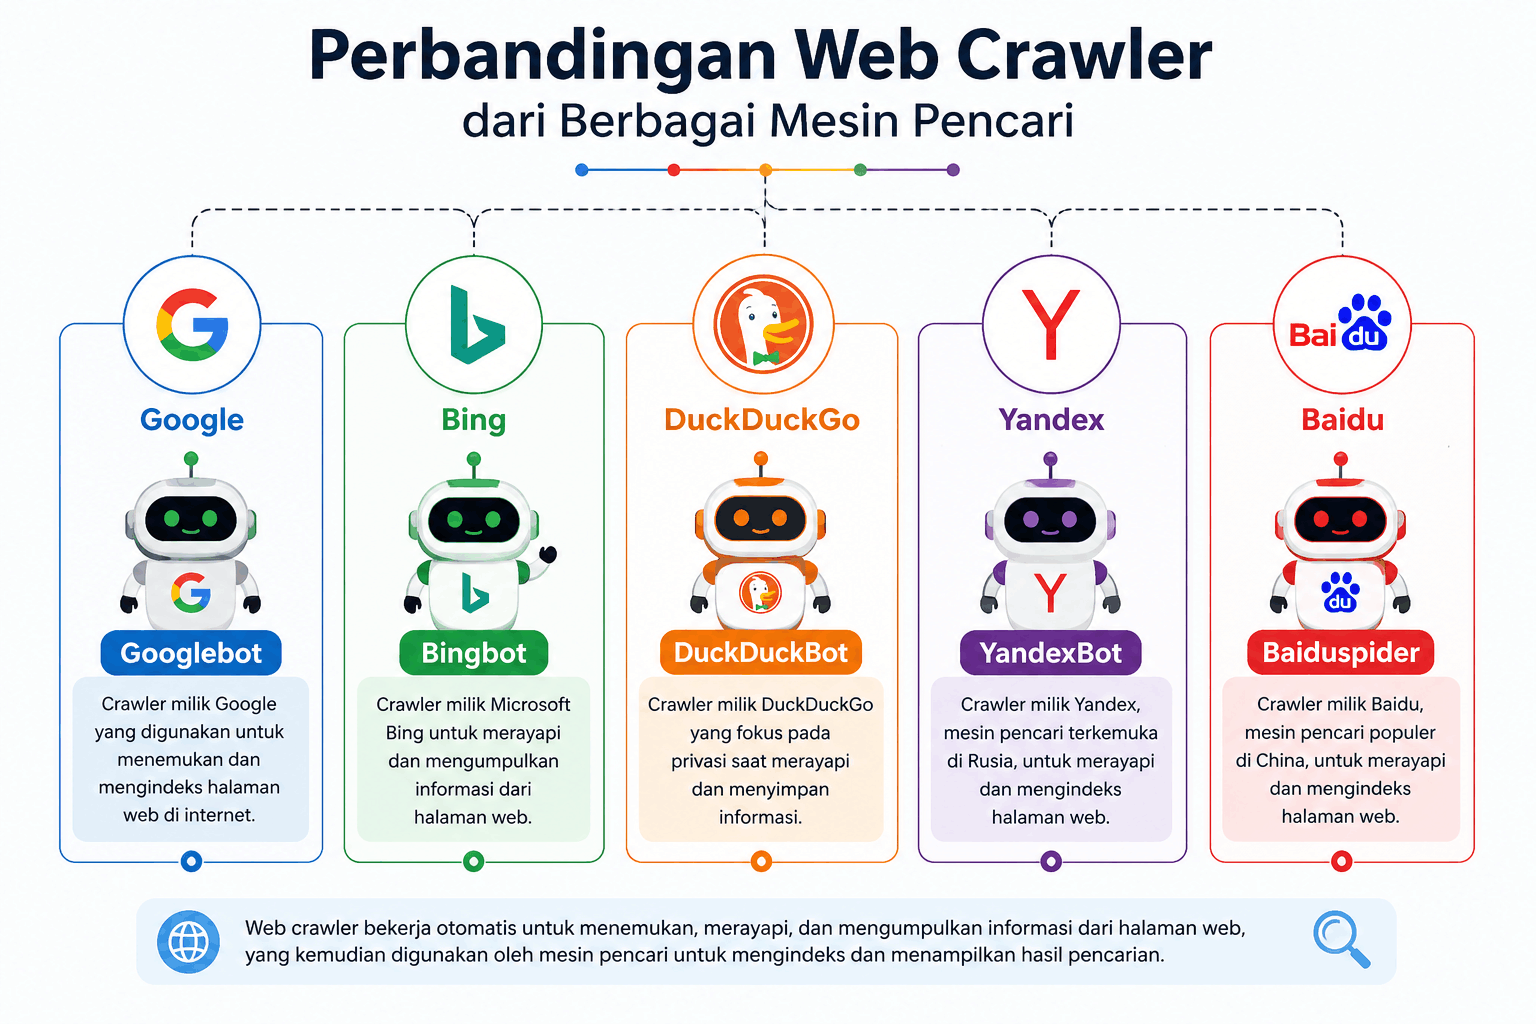
Setiap mesin pencari memiliki web crawler yang berbeda, oleh sebab itu metode yang dipakai web untuk masuk ke database sistem setiap mesin pencari juga berbeda.
Akan tetapi, dikarenakan search engine terbesar di dunia saat ini adalah Google.
Maka sebaiknya Anda melakukan optimasi konten blog atau web anda sesuai ketentuan dari GoogleBot.
Apakah Crawling Sama dengan Indexing?
Tidak. Crawling dan indexing adalah dua proses yang berbeda, meskipun keduanya saling berkaitan dalam cara kerja mesin pencari.
| Crawling | Indexing |
|---|---|
| Googlebot mengakses halaman | Google menganalisis halaman |
| Menemukan URL dan konten | Memahami dan menyimpan informasi |
| Tahap penjelajahan | Tahap pengolahan informasi |
| Tidak otomatis berarti halaman diindeks | Tidak semua halaman pasti masuk indeks |
Sederhananya, crawling adalah proses menemukan dan mengakses halaman, sedangkan indexing adalah proses menganalisis dan menyimpan informasi halaman ke dalam indeks Google.
Jadi, halaman yang sudah di-crawl belum tentu langsung masuk indeks.
Perlu diketahui juga bahwa memblokir crawling melalui robots.txt tidak otomatis mencegah URL muncul di hasil pencarian Google.
Karena itu, crawling dan indexing perlu dipahami sebagai dua tahap yang berbeda dalam proses SEO.
Jenis Web Crawler Berdasarkan Fungsi dan Tujuannya
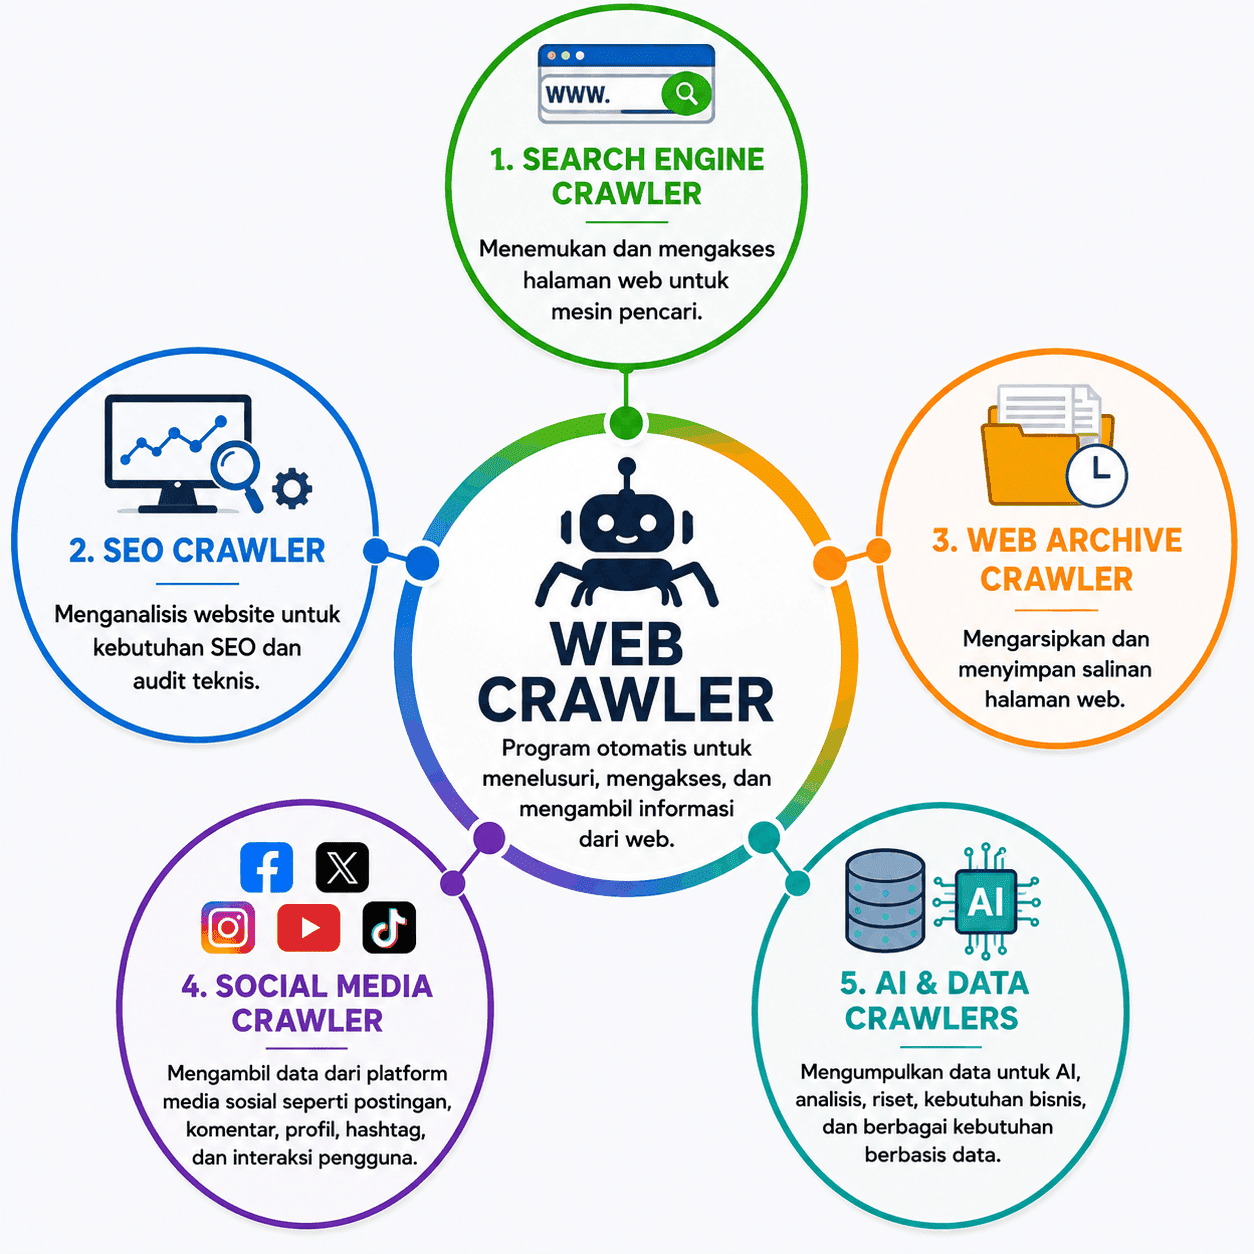
Web crawler dapat digunakan untuk berbagai kebutuhan, sehingga pengelompokannya lebih tepat dilakukan berdasarkan tujuan, fungsi, atau layanan yang menggunakannya.
Dengan pendekatan ini, kita tidak hanya melihat crawler sebagai program untuk mesin pencari, tetapi juga memahami penggunaannya dalam SEO, pengarsipan web, media sosial, layanan AI, dan pengolahan data.
Perlu dipahami bahwa satu istilah seperti image crawler atau news crawler tidak selalu menunjukkan jenis crawler yang benar-benar terpisah.
Sebuah layanan dapat memiliki crawler yang dirancang atau dikonfigurasi untuk mengambil jenis data tertentu sesuai kebutuhannya.
1. Search Engine Crawler
Search engine crawler adalah crawler yang digunakan mesin pencari untuk menemukan dan mengakses halaman web.
Crawler menelusuri URL, mengikuti tautan, serta mengambil informasi dari halaman yang dapat diakses.
Contohnya:
- Googlebot : digunakan oleh Google Search untuk melakukan crawling.
- Bingbot : crawler yang digunakan oleh Microsoft Bing.
- DuckDuckBot : crawler yang digunakan oleh DuckDuckGo.
Dalam proses SEO, search engine crawler sangat penting karena menjadi salah satu tahap awal sebelum mesin pencari dapat memproses dan memahami sebuah halaman.
Namun, halaman yang berhasil di-crawl tidak otomatis masuk indeks. Crawling dan indexing merupakan proses yang berbeda.
Google juga memiliki berbagai crawler dan fetcher dengan fungsi yang berbeda untuk berbagai produk dan kebutuhan.
2. SEO Crawler
SEO crawler adalah crawler yang digunakan untuk melakukan pemeriksaan dan audit terhadap website.
Berbeda dengan crawler mesin pencari yang digunakan sebagai bagian dari sistem pencarian, SEO crawler biasanya digunakan oleh pemilik website, SEO specialist, atau tool SEO untuk menemukan masalah teknis.
SEO crawler dapat membantu memeriksa:
- URL yang menghasilkan error 4xx atau 5xx.
- Title tag dan meta description.
- Struktur heading.
- Internal link dan external link.
- Canonical URL.
- Redirect.
- Robots.txt.
- Noindex.
- Struktur website.
- Halaman yang sulit ditemukan.
- Duplikasi konten.
- Masalah teknis lainnya.
Dengan demikian, SEO crawler dapat membantu pemilik website mengetahui bagaimana sebuah situs dapat dilihat dari sudut pandang crawler.
3. Web Archive Crawler
Web archive crawler digunakan untuk mengumpulkan dan mengarsipkan halaman web.
Tujuannya bukan terutama untuk menentukan peringkat halaman di mesin pencari, tetapi untuk menyimpan dokumentasi web sehingga informasi tertentu dapat dipelajari atau diakses kembali pada masa mendatang.
Crawler jenis ini dapat mengunjungi halaman web, mengambil konten yang tersedia, kemudian menyimpannya sebagai bagian dari arsip.
Pengarsipan dapat berguna untuk:
- Dokumentasi perubahan website.
- Penelitian.
- Dokumentasi sejarah internet.
- Referensi akademik.
- Menyimpan versi halaman yang mungkin berubah atau tidak lagi tersedia.
4. Social Media Crawler
Social media crawler digunakan oleh platform media sosial untuk mengambil informasi tertentu dari URL yang dibagikan pengguna.
Misalnya, ketika sebuah artikel dibagikan ke media sosial, platform dapat mengambil informasi dari halaman tersebut untuk membuat link preview. Informasi yang diambil dapat berupa:
- Judul halaman.
- Deskripsi.
- Gambar utama.
- URL.
- Informasi metadata tertentu.
Jadi, social media crawler tidak selalu digunakan untuk mengindeks seluruh isi website.
Tujuannya dapat lebih spesifik, misalnya mengambil informasi yang diperlukan untuk menampilkan pratinjau sebuah tautan.
5. AI dan Data Crawlers
Perkembangan layanan AI membuat aktivitas crawling semakin beragam.
AI dan data crawlers dapat digunakan untuk berbagai tujuan, termasuk pengumpulan data, pencarian, analisis, pengembangan produk AI, atau layanan berbasis agen.
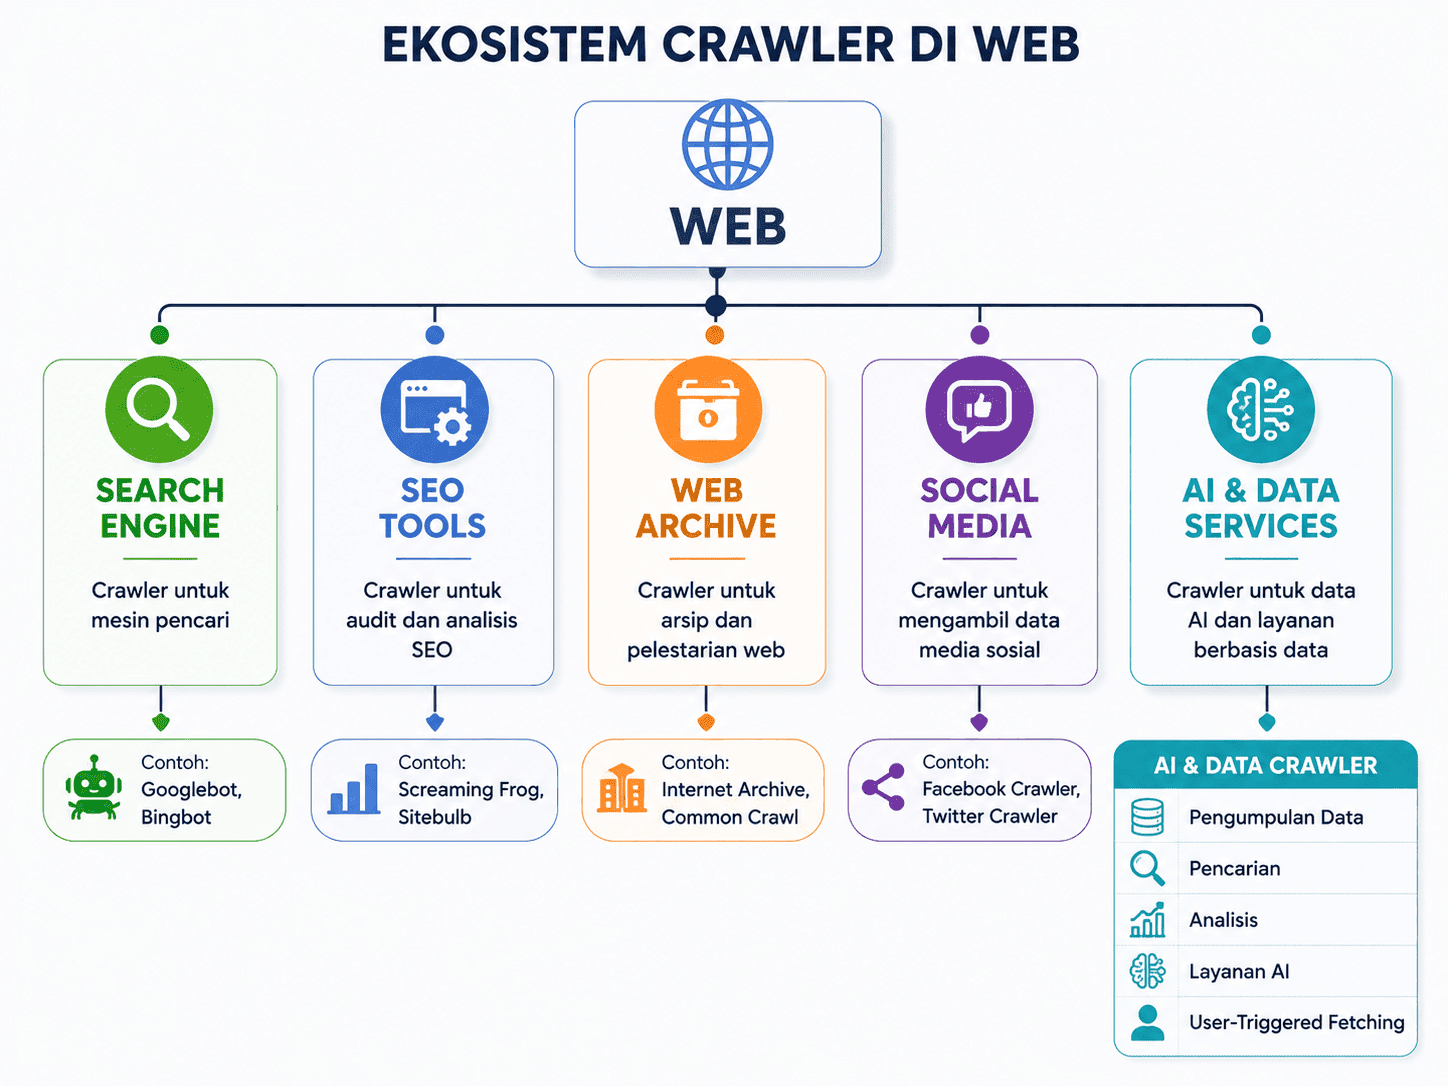
Namun, penting untuk tidak menyamaratakan semua AI crawler. Setiap crawler dapat memiliki fungsi, pemilik, mekanisme akses, dan kebijakan yang berbeda.
Google sendiri menjelaskan bahwa infrastrukturnya memiliki berbagai crawler dan fetcher untuk produk serta kebutuhan yang berbeda.
Selain crawler untuk Google Search, terdapat crawler atau fetcher yang berkaitan dengan produk dan fungsi lain.
Contohnya, Google memiliki Google-Extended, yang merupakan token kontrol bagi publisher terkait penggunaan konten untuk beberapa produk AI Google.
Google juga memiliki crawler lain yang digunakan untuk kebutuhan tertentu, termasuk GoogleOther, GoogleOther-Image, dan GoogleOther-Video.
Google menjelaskan bahwa GoogleOther-Image dan GoogleOther-Video dioptimalkan untuk mengambil data berupa byte gambar dan video untuk kebutuhan penelitian dan pengembangan.
Selain itu, Google juga memiliki user-triggered fetchers, yaitu fetcher yang dijalankan karena permintaan pengguna dalam produk tertentu.
Contohnya adalah fetcher untuk Gemini Notebook yang mengambil URL yang diberikan pengguna sebagai sumber untuk proyek mereka.
Hal ini menunjukkan bahwa pada perkembangan web saat ini, crawler tidak hanya berkaitan dengan mesin pencari.
Crawler dapat digunakan untuk berbagai kebutuhan, sehingga fungsi crawler lebih penting untuk diperhatikan daripada sekadar nama atau kategorinya.
Googlebot Smartphone vs Googlebot Desktop
Apa Itu Googlebot?
Googlebot adalah nama umum untuk crawler yang digunakan oleh Google Search untuk menemukan dan mengakses halaman web.
Googlebot mengunjungi halaman, mengikuti tautan, mengambil informasi yang dapat diakses, kemudian membawa data tersebut ke sistem Google untuk diproses lebih lanjut.
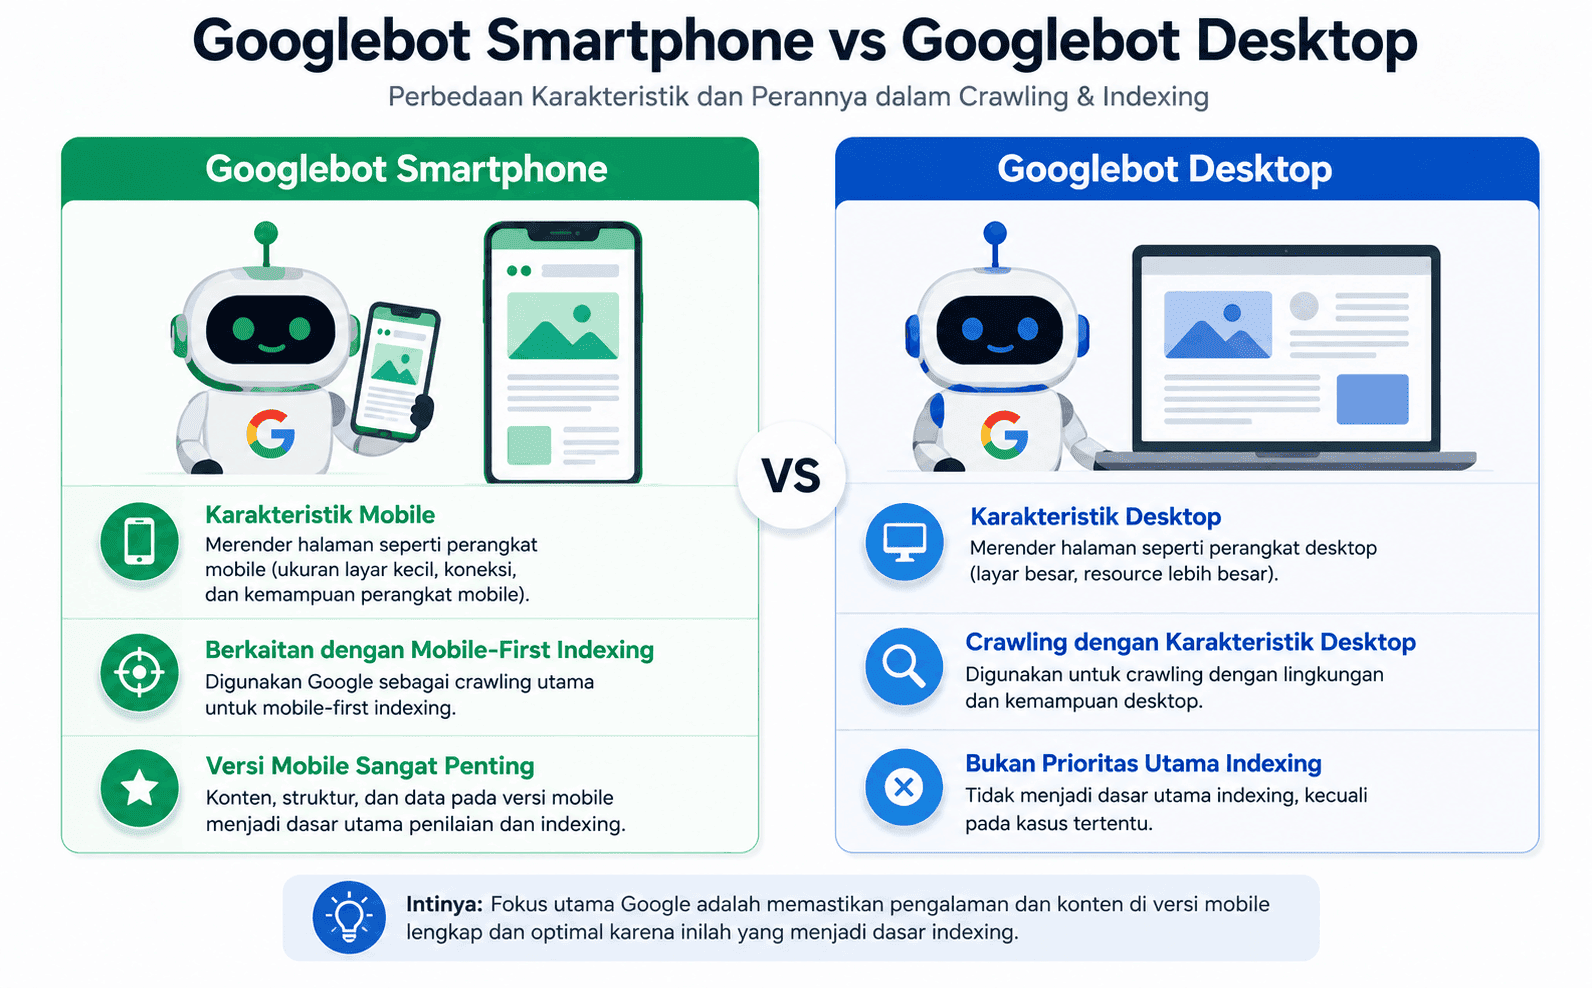
Dalam praktiknya, Google menggunakan beberapa jenis user-agent Googlebot, termasuk Googlebot Smartphone dan Googlebot Desktop. Keduanya digunakan untuk melakukan crawling dengan karakteristik perangkat yang berbeda.
Googlebot Smartphone
Googlebot Smartphone adalah crawler Google yang melakukan crawling dengan karakteristik perangkat mobile.
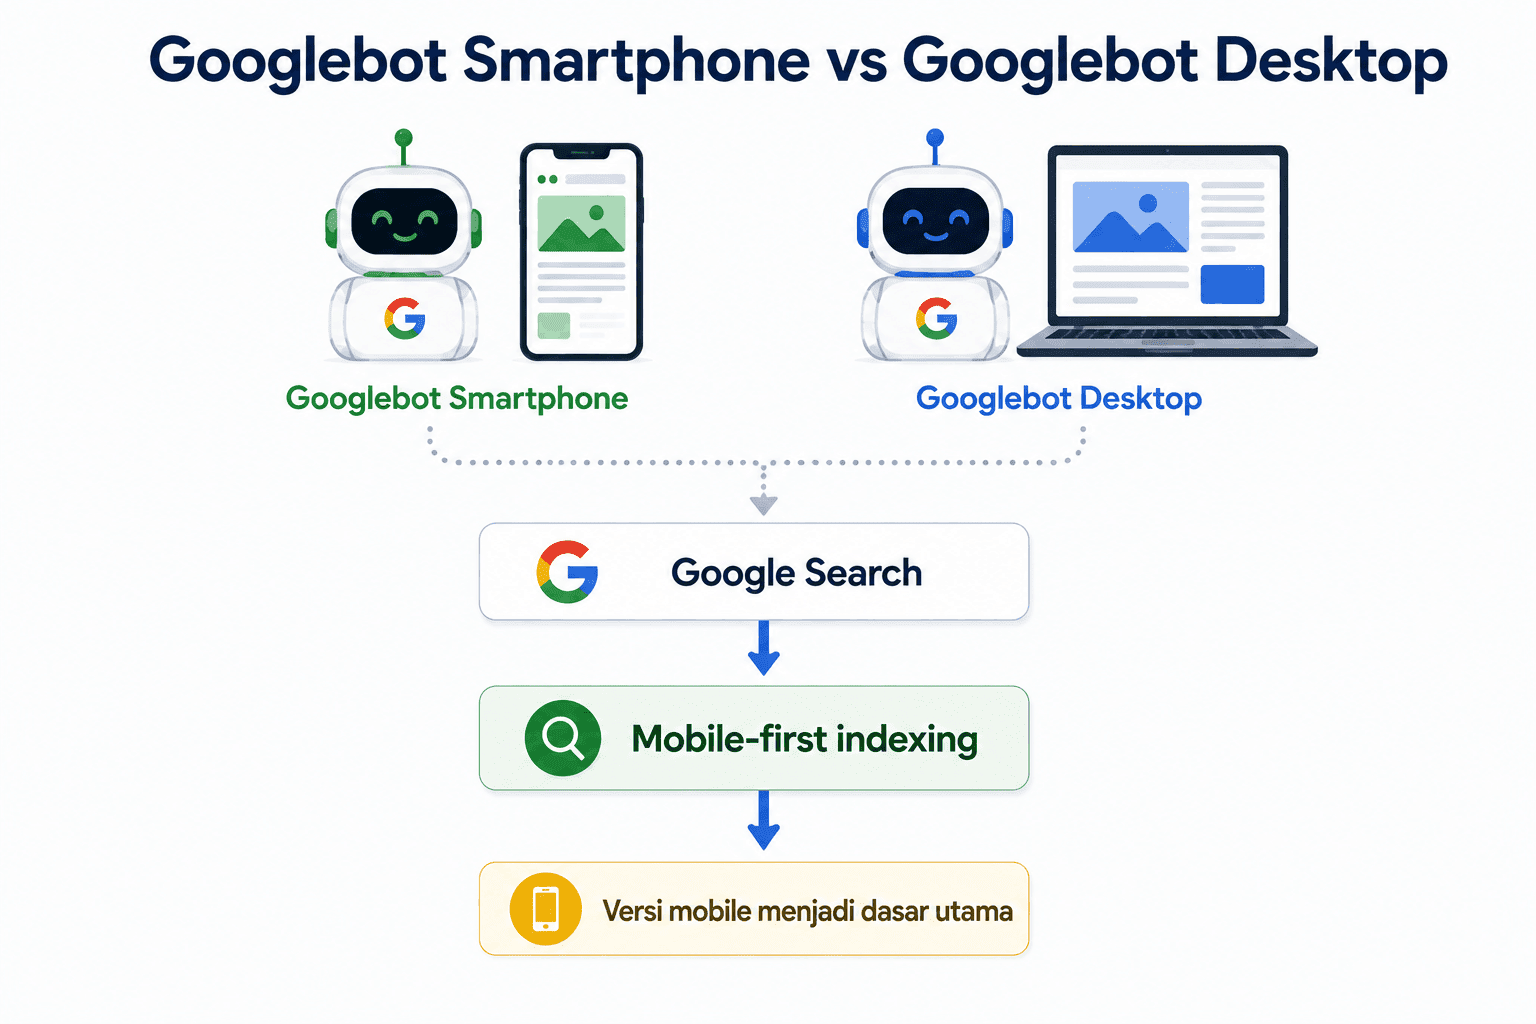
Crawler ini penting karena Google menggunakan versi mobile halaman sebagai dasar untuk proses mobile-first indexing.
Artinya, Google terutama menggunakan konten yang ditemukan melalui Googlebot Smartphone untuk mengindeks dan menentukan informasi yang digunakan dalam Google Search.
Karena itu, website sebaiknya memastikan bahwa konten penting pada versi mobile tetap tersedia dan dapat diakses oleh Google.
Jika konten utama hanya tersedia pada versi desktop tetapi tidak ada pada versi mobile, hal tersebut dapat memengaruhi informasi yang dapat digunakan Google dalam proses indexing.
Googlebot Desktop
Googlebot Desktop adalah crawler yang melakukan crawling dengan karakteristik perangkat desktop. Google masih menyediakan Googlebot dengan karakteristik desktop untuk kebutuhan crawling tertentu.
Namun, keberadaan Googlebot Desktop tidak berarti Google kembali menggunakan desktop sebagai prioritas utama indexing.
Untuk mobile-first indexing, Google menggunakan versi mobile yang di-crawl dengan smartphone agent sebagai dasar indexing dan ranking.
Apa Itu User-Agent Googlebot?
User-agent adalah informasi yang dikirimkan oleh crawler melalui HTTP request untuk mengidentifikasi dirinya kepada server.
Dengan user-agent, pemilik website dapat mengetahui crawler apa yang melakukan permintaan ke server. Google juga menggunakan user-agent tertentu untuk membedakan crawler dan fetcher berdasarkan fungsi masing-masing.
Namun, user-agent tidak boleh dianggap sebagai bukti mutlak bahwa sebuah request benar-benar berasal dari Google karena dapat dipalsukan oleh crawler lain.
Google menyarankan verifikasi menggunakan reverse DNS atau mencocokkan alamat IP dengan daftar IP Googlebot.
Googlebot Smartphone dan Mobile-First Indexing
Mobile-first indexing berarti Google menggunakan versi mobile dari konten website yang di-crawl dengan smartphone agent sebagai dasar utama untuk indexing dan ranking.
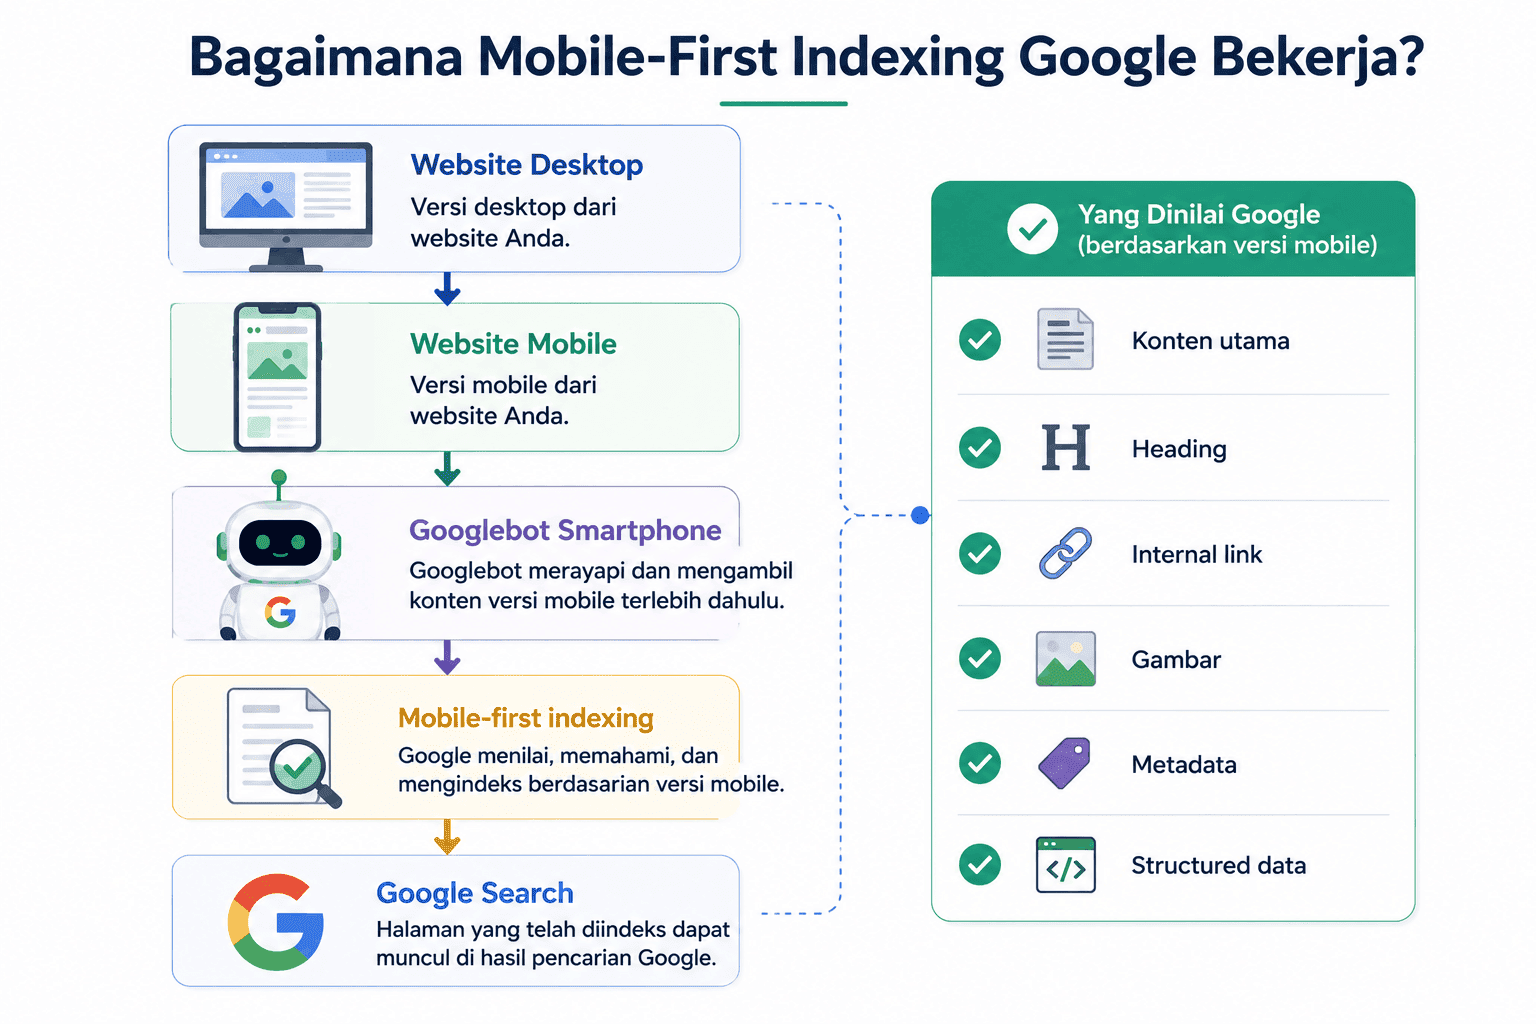
Karena itu, pemilik website perlu memastikan versi mobile memiliki informasi penting yang sama dengan versi desktop, termasuk:
- Konten utama.
- Judul dan heading.
- Internal link.
- Gambar penting.
- Metadata yang relevan.
- Data terstruktur jika digunakan.
Jadi, perbedaan Googlebot Smartphone dan Googlebot Desktop lebih berkaitan dengan karakteristik perangkat yang digunakan saat crawling, bukan berarti keduanya merupakan dua mesin pencari yang berbeda.
Apakah Googlebot Smartphone dan Desktop Memiliki Robots.txt yang Berbeda?
Untuk aturan robots.txt, Google menggunakan token produk Googlebot untuk crawler Google Search. Jadi, pemilik website tidak perlu membuat aturan robots.txt terpisah hanya untuk membedakan Googlebot Smartphone dan Googlebot Desktop.
Hal yang lebih penting adalah memastikan aturan crawling tidak secara tidak sengaja memblokir sumber daya atau halaman penting yang dibutuhkan Google untuk memahami versi mobile website.
Dengan memahami Googlebot Smartphone, Googlebot Desktop, user-agent, dan mobile-first indexing, pemilik website dapat lebih memahami bagaimana Google mengakses website dan mengapa kualitas versi mobile menjadi sangat penting dalam SEO modern.
Apa Saja Fungsi Web Crawler?
Web crawler memiliki fungsi utama untuk menemukan, mengakses, mengambil, dan memproses informasi dari halaman web secara otomatis.
Namun, fungsi crawler tidak hanya berkaitan dengan mesin pencari.
Crawler juga dapat digunakan untuk audit SEO, pengarsipan web, pengumpulan data, pemantauan perubahan halaman, hingga layanan tertentu yang membutuhkan informasi dari URL.
Berikut beberapa fungsi utama web crawler:
1. Menemukan dan Menjelajahi URL
Fungsi pertama web crawler adalah menemukan URL yang tersedia di internet dan menjelajahi halaman-halaman yang dapat diakses.
Crawler dapat menemukan URL baru melalui tautan internal, sitemap, halaman yang sebelumnya sudah diketahui, atau sumber URL lainnya.
Setelah menemukan sebuah halaman, crawler dapat mengikuti tautan yang terdapat di dalam halaman tersebut untuk menemukan URL lain.
Contohnya:
Artikel A → Internal Link → Artikel B → Internal Link → Artikel C
Dengan cara tersebut, crawler dapat menjelajahi berbagai bagian website secara bertahap.
Karena itu, struktur internal link yang jelas dan logis dapat membantu crawler menemukan halaman penting dalam sebuah website.
2. Mengakses dan Mengambil Konten Halaman
Setelah menemukan URL, crawler mengakses halaman melalui permintaan ke server website.
Crawler kemudian mengambil informasi yang dapat diakses, seperti HTML, teks, tautan, gambar, dan sumber daya lain yang diperlukan.
Respons server dapat menunjukkan kondisi halaman, misalnya:
- HTTP 200 : halaman berhasil diakses.
- 301 atau 308 : halaman mengarahkan crawler ke URL lain.
- 404 : halaman tidak ditemukan.
- 5xx :terjadi masalah pada sisi server.
Informasi yang diperoleh dari proses tersebut kemudian dapat diteruskan ke sistem yang menggunakan crawler.
3. Menemukan Halaman Baru dan Perubahan Halaman
Web crawler tidak hanya menemukan halaman baru, tetapi juga dapat mengunjungi kembali halaman yang sebelumnya sudah diketahui.
Ketika sebuah artikel diperbarui, informasi pada halaman berubah, atau terdapat perubahan tertentu pada website, crawling ulang dapat membantu sistem mengetahui perubahan tersebut.
Namun, crawling ulang tidak berarti halaman pasti langsung diperbarui di indeks atau mendapatkan peringkat yang lebih baik.
Setelah halaman diakses kembali, masih terdapat proses pengolahan dan evaluasi.
Dengan demikian, crawler berperan dalam membantu sistem menemukan konten baru maupun perubahan pada konten yang sudah ada.
4. Menyediakan Informasi untuk Diproses Mesin Pencari
Pada mesin pencari seperti Google, crawler mengambil informasi dari halaman web untuk kemudian diproses oleh sistem pencarian.
Informasi tersebut dapat mencakup konten halaman, struktur HTML, tautan, gambar, serta sumber daya lain yang diperlukan untuk memahami halaman.
Crawling merupakan salah satu tahap awal sebelum informasi dapat diproses untuk indexing.
Secara sederhana:
Crawling → Pengolahan → Indexing → Serving & Ranking
Perlu dipahami bahwa crawler tidak melakukan indexing secara langsung.
Crawler bertugas menemukan dan mengambil informasi, sedangkan informasi tersebut kemudian diproses oleh sistem mesin pencari.
Karena itu, halaman yang berhasil di-crawl belum tentu otomatis masuk ke Google Index.
5. Mengambil dan Memproses Sumber Daya Halaman
Crawler tidak selalu hanya mengambil teks dari HTML. Pada website modern, sistem juga dapat mengambil sumber daya lain yang diperlukan untuk memahami halaman.
Sumber daya tersebut dapat mencakup:
- CSS.
- JavaScript.
- Gambar.
- File tertentu.
- Sumber daya lain yang diperlukan untuk menampilkan atau memahami halaman.
Hal ini menjadi semakin penting pada website yang menggunakan JavaScript. Dalam kondisi tertentu, Google dapat melakukan proses rendering untuk membantu memahami konten yang dihasilkan atau diubah oleh JavaScript.
Karena itu, pemilik website perlu memastikan bahwa informasi penting tidak hanya tersedia bagi pengguna, tetapi juga dapat diakses dan diproses oleh sistem mesin pencari.
6. Membantu Menemukan Masalah Teknis Website
Crawler juga dapat digunakan untuk melakukan audit terhadap website.
Dalam SEO, SEO crawler dapat membantu menemukan berbagai masalah teknis yang mungkin sulit ditemukan secara manual.
Contohnya:
- Halaman dengan status HTTP 404 atau 5xx.
- Internal link yang rusak.
- Redirect yang bermasalah.
- Canonical yang tidak sesuai.
- Halaman dengan
noindex. - Duplikasi URL.
- Struktur website yang terlalu kompleks.
- Halaman penting yang sulit ditemukan.
Dengan melakukan crawling terhadap seluruh website, pemilik website dapat memperoleh gambaran mengenai struktur dan berbagai masalah teknis yang terdapat di dalamnya.
7. Membantu Pengelolaan Crawling Website
Crawler juga berhubungan dengan bagaimana mesin pencari mengalokasikan sumber daya untuk mengunjungi sebuah website.
Website dengan jumlah URL yang sangat besar, banyak URL duplikat, atau struktur yang tidak efisien dapat membuat proses crawling menjadi lebih kompleks.
Google menggunakan konsep crawl budget untuk menjelaskan sumber daya yang dialokasikan untuk crawling sebuah website.
Crawl budget berkaitan antara lain dengan kemampuan server dan kebutuhan Google untuk melakukan crawling terhadap situs tersebut.
Karena itu, pemilik website sebaiknya menjaga struktur URL tetap sederhana, menghindari URL yang tidak diperlukan, memperbaiki masalah server, dan memastikan halaman penting dapat ditemukan melalui struktur internal link yang baik.
8. Mendukung Pengarsipan, Pengumpulan Data, dan Layanan Tertentu
Di luar mesin pencari, web crawler dapat digunakan untuk berbagai kebutuhan lain.
Crawler dapat digunakan untuk:
- Mengarsipkan halaman web.
- Mendokumentasikan perubahan website.
- Melakukan penelitian.
- Mengumpulkan data tertentu.
- Memantau perubahan informasi.
- Mengambil informasi untuk layanan tertentu.
- Membuat link preview pada platform atau layanan tertentu.
Hal ini menunjukkan bahwa web crawler bukan hanya digunakan oleh mesin pencari.
Pada dasarnya, crawler adalah program otomatis yang dapat menelusuri dan mengambil informasi dari web sesuai dengan tujuan layanan yang menggunakannya.
Bagaimana Cara Kerja Web Crawler?
Web crawler bekerja secara otomatis dengan menjelajahi halaman web, menemukan URL, mengambil informasi, kemudian meneruskan data tersebut ke sistem yang menggunakannya.
Pada mesin pencari seperti Google, proses ini menjadi bagian awal sebelum halaman dianalisis dan dipertimbangkan untuk masuk ke indeks.
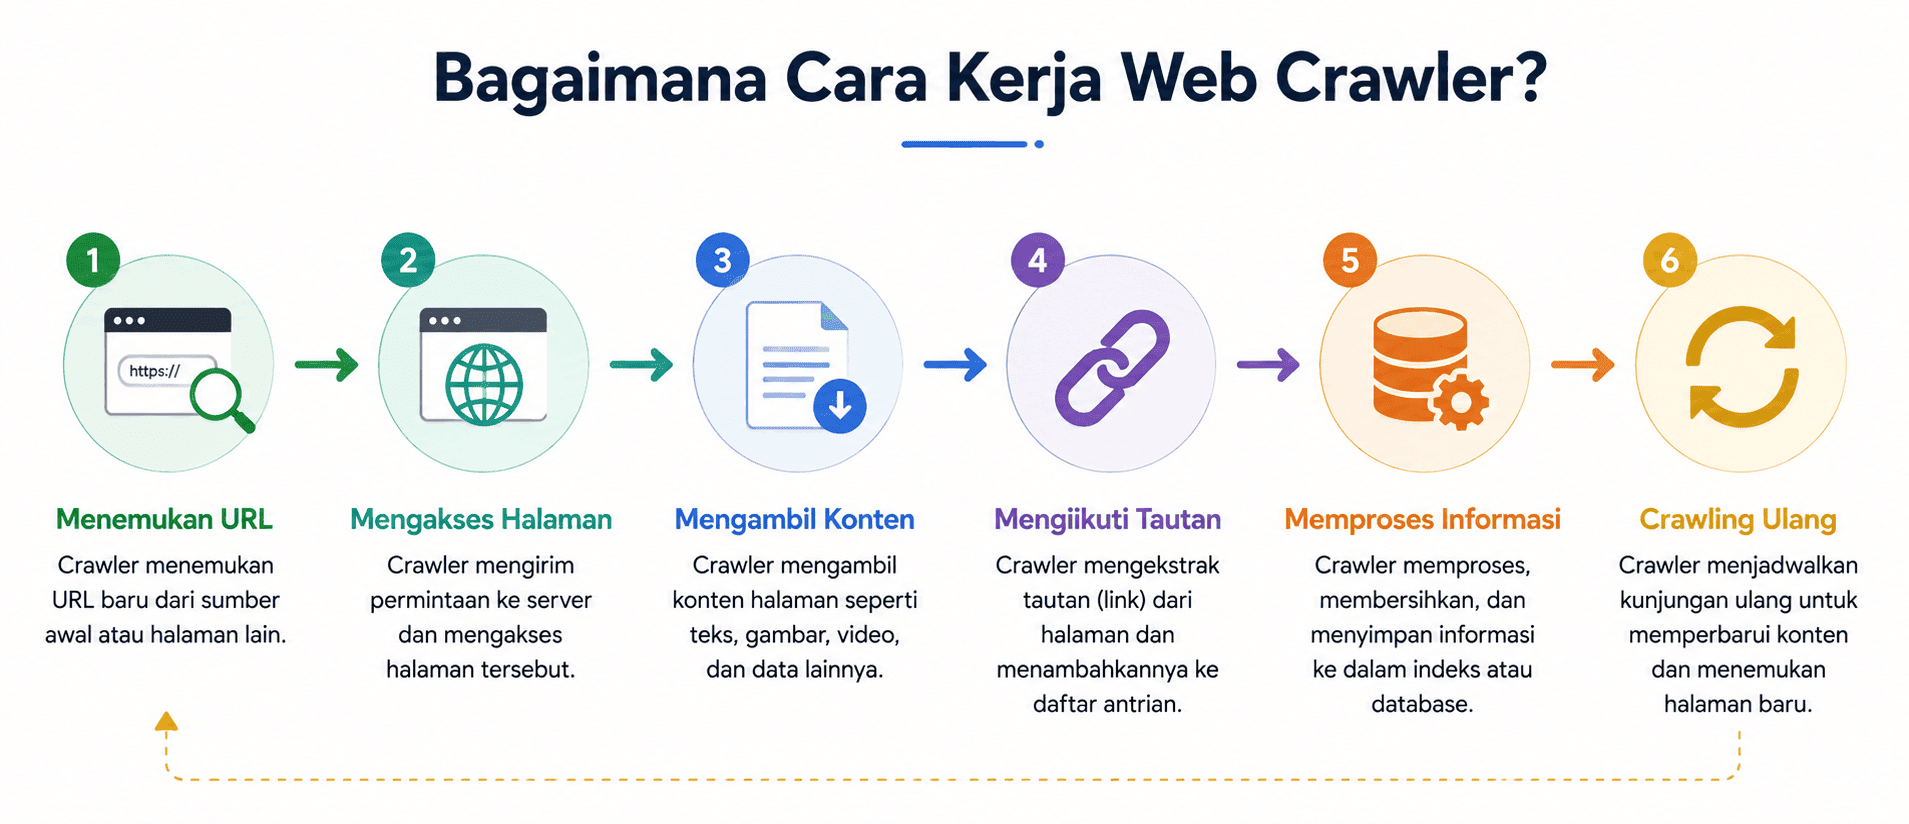
Secara sederhana, cara kerja web crawler dapat digambarkan sebagai berikut:
1. Crawler Menemukan URL
Proses dimulai ketika crawler memperoleh URL yang perlu dikunjungi. URL tersebut dapat berasal dari halaman yang sudah diketahui, tautan dari halaman lain, sitemap, atau sumber URL lainnya.
Misalnya, crawler sudah mengetahui halaman:
https://jokowa.id/artikel-a/
Di dalam halaman tersebut terdapat tautan menuju:
https://jokowa.id/artikel-b/
Crawler dapat mengikuti tautan tersebut sehingga menemukan URL baru. Inilah sebabnya struktur internal link yang baik dapat membantu crawler menemukan halaman dalam sebuah website.
Crawler juga tidak selalu memulai dari halaman yang benar-benar baru. Halaman yang sudah pernah dikunjungi dapat dijadwalkan untuk di-crawl kembali ketika sistem memperkirakan perlu memeriksa perubahan terbaru.
2. Crawler Mengakses Halaman
Setelah menemukan URL, crawler mengirimkan permintaan kepada server website untuk mengambil halaman tersebut.
Server kemudian memberikan respons, misalnya halaman berhasil diakses dengan status HTTP 200, diarahkan ke URL lain melalui redirect, atau tidak ditemukan dengan status 404.
Pada tahap ini, crawler juga mengikuti aturan akses yang berlaku. Salah satu mekanisme yang digunakan website adalah robots.txt, yang dapat memberikan instruksi kepada crawler mengenai bagian tertentu yang boleh atau tidak boleh diakses.
Namun, robots.txt perlu dipahami dengan benar. Memblokir crawling terhadap sebuah URL tidak sama dengan menghapus URL tersebut dari mesin pencari.
URL yang tidak dapat di-crawl masih dapat diketahui Google dari sumber lain dan dalam kondisi tertentu tetap dapat muncul di hasil pencarian.
3. Crawler Mengambil dan Memahami Sumber Daya Halaman
Setelah halaman berhasil diakses, crawler mengambil informasi yang tersedia. Informasi tersebut dapat mencakup HTML, teks, tautan, gambar, dan sumber daya lain yang diperlukan.
Pada website modern, halaman juga dapat menggunakan JavaScript untuk menampilkan atau mengubah konten.
Dalam kasus tertentu, sistem Google dapat melakukan proses rendering untuk melihat konten yang dihasilkan oleh JavaScript sebelum informasi tersebut diproses lebih lanjut.
Karena itu, website sebaiknya tidak hanya memastikan halaman dapat dibuka oleh pengguna, tetapi juga memastikan konten penting dapat diakses dan dipahami oleh crawler.
4. Crawler Mengikuti Tautan dan Menemukan Halaman Lain
Setelah membaca halaman, crawler dapat menemukan tautan menuju URL lain. Tautan tersebut kemudian dapat menjadi sumber URL berikutnya yang akan dikunjungi.
Contohnya:
Homepage → Kategori → Artikel → Artikel terkait → Halaman lainnya
Dengan cara tersebut, crawler dapat menjelajahi banyak bagian dalam sebuah website.
Sitemap juga dapat membantu memberikan daftar URL yang ingin ditemukan oleh mesin pencari.
Namun, memasukkan URL ke sitemap tidak menjamin bahwa URL tersebut pasti di-crawl, di-index, atau mendapatkan peringkat.
5. Data Diproses dan Halaman Dapat Dijadwalkan untuk Crawling Ulang
Setelah informasi diperoleh, data tersebut diteruskan ke sistem yang menggunakan crawler.
Pada mesin pencari, informasi yang diperoleh melalui crawling kemudian dapat diproses untuk tahap berikutnya, termasuk indexing.
Halaman juga dapat dikunjungi kembali. Frekuensi crawling ulang tidak selalu sama untuk setiap halaman.
Halaman yang sering berubah, memiliki permintaan crawling yang berbeda, atau berada pada website dengan kondisi tertentu dapat diperlakukan secara berbeda.
Google menggunakan konsep crawl budget untuk menjelaskan bagaimana sumber daya crawling dialokasikan pada website.
Crawl budget berkaitan antara lain dengan kemampuan server dan kebutuhan crawling sebuah situs. (developers.google.com)
Crawling Tidak Sama dengan Indexing
Hal yang paling penting untuk dipahami adalah bahwa crawling bukan berarti indexing.
Crawling berarti crawler berhasil menemukan dan mengakses halaman. Setelah itu, mesin pencari masih perlu menganalisis dan memproses informasi tersebut untuk menentukan apakah halaman layak dimasukkan ke indeks.
Alurnya dapat disederhanakan menjadi:
Website → Crawling → Analisis & Pemrosesan → Indexing → Serving & Ranking
Jadi, apabila sebuah halaman sudah di-crawl, bukan berarti halaman tersebut otomatis masuk Google Index. Begitu pula halaman yang sudah masuk indeks tidak otomatis mendapatkan posisi tinggi di hasil pencarian.
Tips Penting Lainnya Untuk Memudahkan Google Crawling
Setelah memahami cara kerja web crawler, langkah berikutnya adalah memastikan website mudah ditemukan dan diakses oleh Googlebot.
Website yang memiliki struktur jelas, server yang stabil, serta URL dan internal link yang baik akan membantu Google menemukan halaman secara lebih efisien.
Namun, perlu dipahami bahwa memudahkan crawling tidak berarti menjamin halaman akan diindeks atau mendapatkan peringkat tinggi di Google. Crawling, indexing, dan ranking merupakan proses yang berbeda.
1. Buat Struktur Website dan Internal Link yang Jelas
Googlebot menemukan banyak URL melalui tautan. Karena itu, struktur internal link yang baik membantu Google menemukan halaman penting di dalam website.
Pastikan halaman utama, kategori, dan artikel saling terhubung secara logis. Gunakan anchor text yang jelas sehingga pengguna maupun mesin pencari dapat memahami konteks halaman yang dituju.
Contohnya:
Homepage → Kategori SEO → Artikel SEO → Artikel terkait
Hindari halaman penting yang hanya dapat ditemukan melalui pencarian internal atau tidak memiliki tautan dari halaman lain. Halaman seperti ini lebih sulit ditemukan crawler.
2. Gunakan Sitemap XML
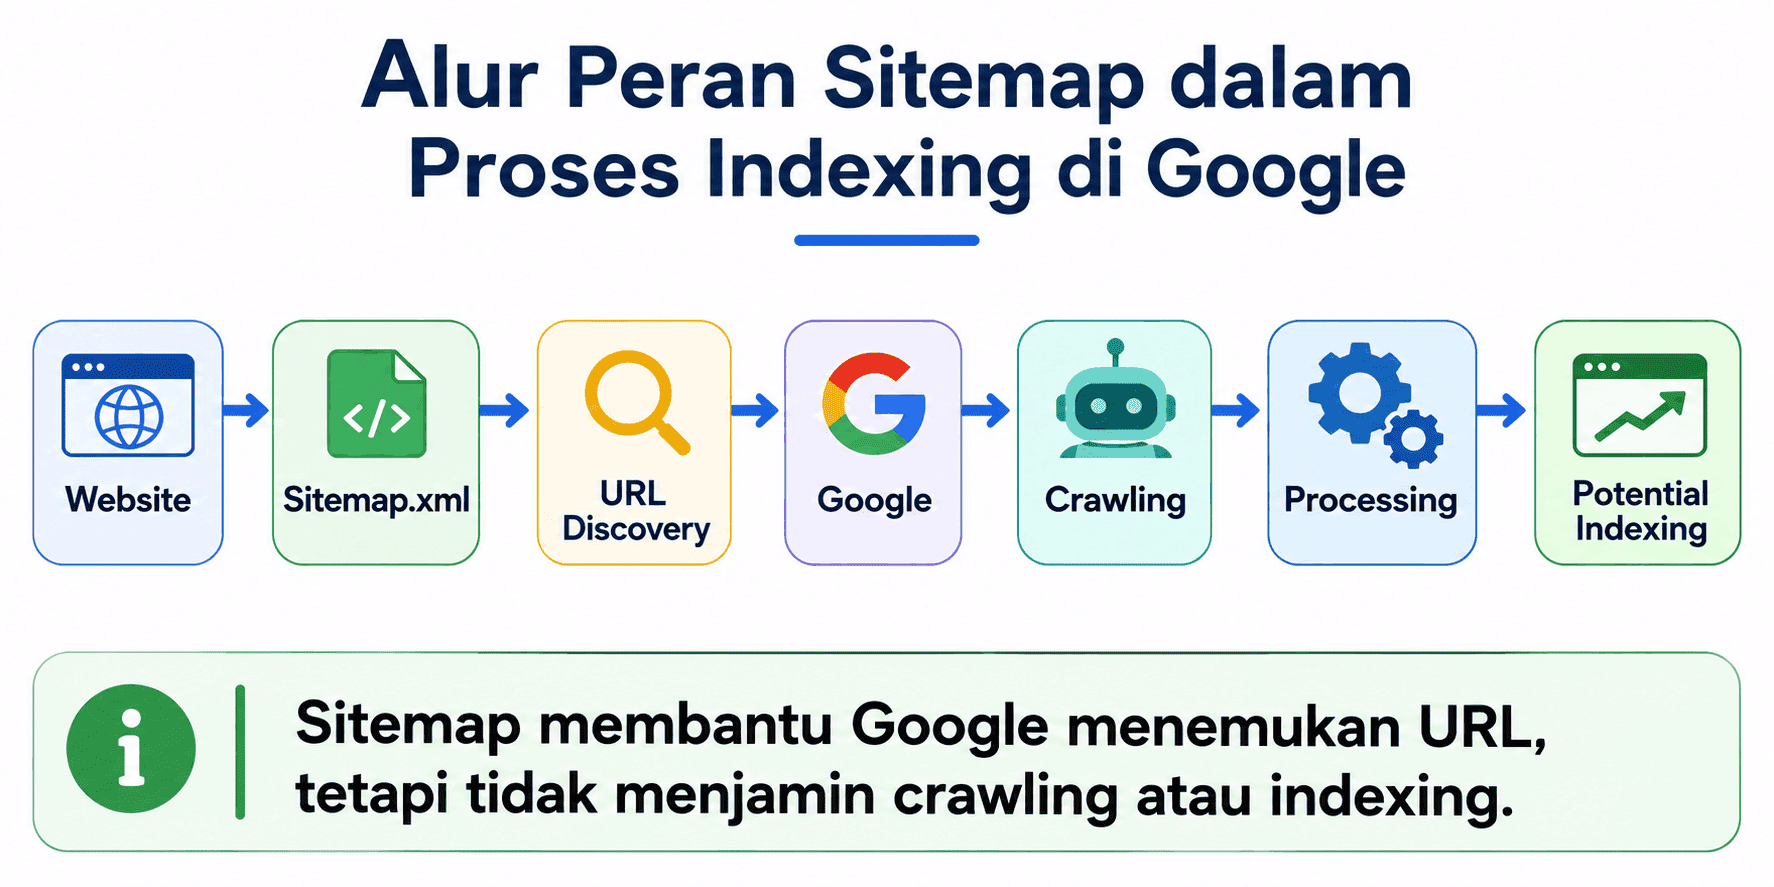
Sitemap XML membantu memberikan daftar URL penting yang ingin Anda sampaikan kepada mesin pencari.
Sitemap sangat berguna terutama untuk website yang memiliki banyak halaman, struktur yang kompleks, atau halaman baru yang terus bertambah.
Pastikan sitemap hanya berisi URL yang memang ingin dipertimbangkan untuk crawling dan indexing. Hindari memasukkan URL error, URL redirect, atau halaman yang sengaja tidak ingin diindeks.
Sitemap dapat dikirimkan melalui Google Search Console sehingga Google dapat menemukan URL yang tercantum di dalamnya.
Namun, sitemap bukan perintah bahwa semua URL pasti di-crawl atau di-index. Sitemap lebih tepat dipahami sebagai salah satu cara untuk membantu Google menemukan URL.
3. Pastikan robots.txt Tidak Memblokir Halaman Penting
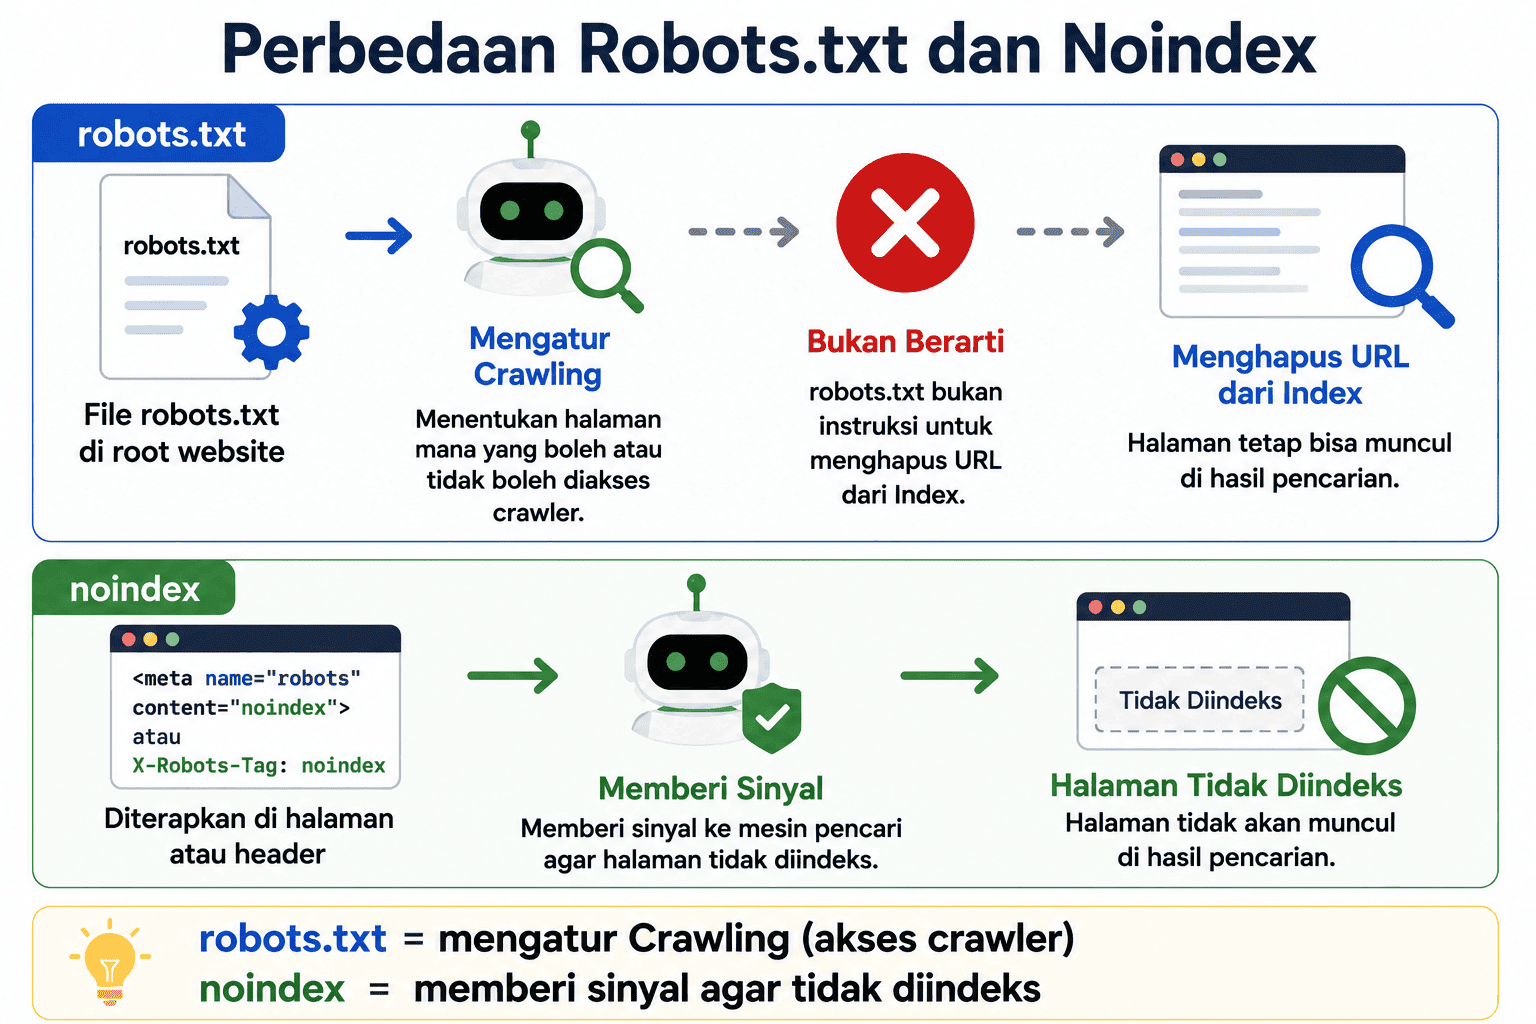
File robots.txt digunakan untuk memberikan aturan kepada crawler mengenai URL atau bagian website yang tidak ingin diakses oleh crawler tertentu.
Kesalahan konfigurasi robots.txt dapat menyebabkan Googlebot tidak dapat mengakses halaman atau sumber daya yang sebenarnya penting.
Karena itu, periksa apakah aturan seperti:
Disallow: /
atau aturan Disallow lainnya secara tidak sengaja memblokir bagian penting website.
Perlu diperhatikan bahwa robots.txt mengatur crawling, bukan secara langsung menghapus halaman dari Google Index. Jika tujuan Anda adalah mencegah halaman muncul dalam hasil pencarian, mekanisme seperti noindex perlu dipahami dan digunakan sesuai kebutuhan.
4. Perhatikan Kecepatan dan Stabilitas Server
Googlebot tetap membutuhkan respons dari server untuk mengambil halaman.
Jika server sering mengalami timeout, lambat memberikan respons, atau mengalami error, proses crawling dapat menjadi kurang efisien.
Karena itu, pastikan hosting dan server mampu menangani permintaan crawler maupun pengguna.
Beberapa hal yang perlu diperhatikan antara lain:
- Waktu respons server.
- Error HTTP yang berlebihan.
- Server sering mengalami downtime.
- Kapasitas hosting.
- Beban website ketika mendapatkan banyak permintaan.
Google juga memperhitungkan kemampuan server dalam konsep crawl budget. Jika server mampu merespons dengan baik, Google dapat melakukan crawling secara lebih efisien. (developers.google.com)
5. Hindari URL yang Tidak Perlu
Website yang memiliki terlalu banyak URL tidak berguna dapat membuat proses crawling menjadi kurang efisien. Contohnya adalah URL duplikat yang dihasilkan oleh parameter, filter, atau sistem navigasi tertentu.
Jika satu halaman dapat diakses melalui banyak URL berbeda, Google mungkin perlu menghabiskan sumber daya untuk memproses URL tersebut.
Karena itu, gunakan struktur URL yang sederhana dan konsisten. Untuk halaman yang memiliki versi URL berbeda, gunakan elemen teknis yang sesuai seperti canonical, redirect, atau aturan lainnya berdasarkan kebutuhan.
6. Pastikan Versi Mobile Dapat Diakses
Google menggunakan mobile-first indexing, sehingga versi mobile website sangat penting. Pastikan konten utama yang tersedia pada desktop juga tersedia pada versi mobile.
Periksa terutama:
- Konten utama.
- Internal link.
- Heading.
- Gambar.
- Metadata.
- Elemen penting lainnya.
Jangan membuat versi mobile yang terlalu berbeda dari versi desktop jika perbedaan tersebut menyebabkan Google kehilangan informasi penting.
7. Perbaiki Internal Link yang Rusak
Internal link yang menghasilkan error dapat menghambat pengguna dan membuat struktur navigasi website menjadi kurang efektif.
Lakukan pemeriksaan secara berkala terhadap link yang:
- Mengarah ke halaman 404.
- Mengarah ke URL yang sudah dipindahkan.
- Menghasilkan terlalu banyak redirect.
- Mengarah ke halaman yang tidak relevan.
Gunakan internal link yang relevan untuk menghubungkan artikel yang masih berada dalam topik yang sama. Selain membantu crawling, struktur ini juga membantu pengguna menemukan informasi tambahan.
8. Gunakan Google Search Console untuk Memantau Crawling
Google Search Console dapat digunakan untuk memantau bagaimana Google berinteraksi dengan website.
Salah satu fitur penting adalah URL Inspection, yang dapat membantu memeriksa status sebuah URL di Google.
Anda dapat menggunakannya untuk mengetahui apakah URL sudah ditemukan, dapat diakses, atau memiliki masalah tertentu yang berkaitan dengan crawling dan indexing.
Namun, jangan melakukan permintaan indexing secara berulang tanpa alasan. Gunakan fitur tersebut terutama ketika Anda memiliki halaman baru atau halaman penting yang baru diperbarui.
Kesimpulan Saya tentang Web Crawler Setelah Mengelola Jokowa.id Lebih dari 10 Tahun
Setelah mengelola Jokowa.id selama lebih dari 10 tahun, saya melihat bahwa web crawler merupakan bagian yang sangat penting dalam perjalanan sebuah website, meskipun prosesnya tidak terlihat secara langsung.
Dari pengalaman tersebut, saya menyadari beberapa hal penting:
- Crawling bukan sekadar Google mengunjungi website. Crawler bekerja dengan menemukan URL, mengakses halaman, mengikuti tautan, dan mengambil informasi yang tersedia untuk diproses lebih lanjut.
- Artikel yang sudah dipublikasikan belum tentu langsung di-crawl dan di-index. Karena itu, membuat artikel saja tidak cukup. Struktur website, internal link, sitemap, dan kondisi teknis juga ikut menentukan seberapa mudah halaman ditemukan dan diakses.
- Crawling dan indexing harus dibedakan. Saya pernah melihat halaman yang sudah berhasil di-crawl tetapi belum masuk indeks. Dari sini saya memahami bahwa crawling hanyalah salah satu tahap sebelum sebuah halaman dapat diproses dan dipertimbangkan untuk masuk Google Index.
- Internal link ternyata sangat penting. Setelah bertahun-tahun mengelola website, saya semakin melihat bahwa artikel yang saling terhubung membentuk struktur informasi yang lebih jelas. Crawler dapat mengikuti hubungan tersebut untuk menemukan halaman lain yang relevan.
- Artikel lama tidak boleh dibiarkan begitu saja. Website terus berkembang, informasi berubah, dan artikel baru terus dibuat. Karena itu, memperbarui artikel lama serta menghubungkannya dengan artikel baru menjadi bagian penting dari pengelolaan website.
- Masalah crawling tidak selalu berasal dari kualitas artikel. URL yang rusak, redirect,
robots.txt,noindex, struktur website, internal link, hingga masalah server juga dapat memengaruhi bagaimana crawler mengakses website. - SEO tidak bisa hanya dilihat dari jumlah artikel. Pengalaman mengelola Jokowa.id membuat saya memahami bahwa website yang sehat membutuhkan keseimbangan antara konten berkualitas, struktur yang jelas, internal linking, aspek teknis, crawling, dan indexing.
Pelajaran Terbesar Saya
Setelah lebih dari 10 tahun mengelola Jokowa.id, saya semakin memahami bahwa Google tidak hanya membaca artikel, tetapi juga menjelajahi seluruh struktur website. Karena itu, saya tidak lagi melihat setiap artikel sebagai halaman yang berdiri sendiri.
Saya melihat website sebagai sebuah ekosistem informasi, di mana setiap artikel harus memiliki hubungan yang jelas dengan artikel lainnya.
Bagi saya, web crawler mengajarkan satu hal penting: membuat website bukan hanya tentang menulis untuk manusia, tetapi juga memastikan mesin pencari dapat menemukan, mengakses, memahami, dan menghubungkan informasi yang kita buat.
Dan yang paling penting, pengalaman selama lebih dari 10 tahun membuat saya menyadari bahwa SEO terus berubah, tetapi prinsip dasarnya tetap sama: buat website yang mudah diakses, mudah dipahami, memiliki struktur yang jelas, dan memberikan informasi yang benar-benar berguna bagi pengguna.
FAQ Web Crawler
Apa itu web crawler?
Web crawler adalah program otomatis yang digunakan untuk menemukan, mengakses, dan mengambil halaman atau sumber daya di internet. Mesin pencari seperti Google menggunakan crawler untuk menemukan URL baru atau halaman yang mengalami perubahan.
Apa fungsi web crawler?
Fungsi utama web crawler adalah menemukan dan mengambil halaman web sehingga mesin pencari dapat memproses informasi dari halaman tersebut. Crawler merupakan bagian dari tahap crawling, sebelum halaman diproses lebih lanjut untuk indexing dan ditampilkan dalam hasil pencarian.
Apa perbedaan crawler dan indexing?
Crawler bertugas mengakses dan mengambil halaman web, sedangkan indexing adalah proses ketika mesin pencari menganalisis dan menyimpan informasi halaman ke dalam indeksnya. Jadi, crawling dan indexing merupakan dua proses yang berbeda.
Apa itu Googlebot?
Googlebot adalah nama umum untuk crawler yang digunakan Google untuk menemukan dan mengakses halaman web. Google memiliki crawler untuk berbagai kebutuhan, termasuk Googlebot Smartphone dan Googlebot Desktop.
Apakah web crawler sama dengan Googlebot?
Tidak. Web crawler adalah istilah umum untuk program yang menjelajahi web, sedangkan Googlebot adalah crawler yang digunakan oleh Google. Dengan kata lain, Googlebot merupakan salah satu contoh web crawler.
Apakah robots.txt menghentikan indexing?
Tidak selalu. robots.txt terutama digunakan untuk mengatur crawling, bukan sebagai cara utama untuk mencegah sebuah halaman diindeks. Jika tujuan Anda adalah meminta Google agar tidak mengindeks halaman, noindex lebih sesuai dalam kondisi yang tepat.
Apakah sitemap menjamin halaman diindeks Google?
Tidak. Sitemap membantu Google menemukan URL yang penting di sebuah website, tetapi mengirimkan sitemap tidak menjamin URL akan dicrawl atau diindeks. Kelayakan indexing tetap ditentukan oleh sistem mesin pencari.
Bagaimana cara mengetahui Googlebot sudah mengunjungi website?
Anda dapat menggunakan Google Search Console, khususnya URL Inspection, untuk memeriksa status crawling dan indexing URL. Data server log juga dapat membantu pemilik website melihat permintaan dari crawler secara lebih teknis.
Mengapa halaman website tidak dicrawl Google?
Ada beberapa kemungkinan, misalnya URL sulit ditemukan, terdapat masalah pada internal linking, robots.txt memblokir akses crawler, server mengalami error atau timeout, sitemap bermasalah, atau Google belum menemukan dan menjadwalkan URL tersebut untuk dicrawl.
Apakah crawler berpengaruh terhadap SEO?
Ya, tetapi perlu dipahami dengan tepat. Crawler membantu mesin pencari menemukan dan mengambil halaman website. Jika halaman sulit dicrawl atau tidak dapat diakses dengan baik, mesin pencari dapat mengalami kesulitan dalam memproses halaman tersebut untuk pencarian.

Biasanya peta situs ini dinamakan sebagai sitemap, adalah bagian terpenting dalam crawling sebab dengan melakukan indeks sitemap ini, membuat seluruh konten artikel dari sebuah web akan terindeks dengan mudah oleh Google sesuai algoritma Google. oh ternyata seperti ini, baru tahu ya ternyata dunia internet begitu kompleks.
Ya, bnyk plugin jg yg memudahkan utk web crowling ini. Thx min atas penjelasannya, bisa lebih paham jadinya jika ga pengen pake plugin dan dilakukan secara manual 🙂
kalo di blogspot atau blogger plugginnya g ada ya, kalo wordpress banyak plugin yg bermanfaat
plugin khusus untuk WP kak, kalau di blogspot gak ada plugin, tapi bisa di setting di kode htmlnya..
Crowling memudahkan masyarakat dalam menemukan dan membuat data. Semakin canggih teknologi, manusia juga harus semakin berkembang